Портфолио
Анализатор аудио и видеоконтента
Решение для PR-агентств, маркетологов и аналитиков, автоматизирующее анализ теле- и радиоэфира. Система обеспечивает преобразование речи в текст, идентификацию спикеров, семантическую сегментацию контента и распознавание лейблов, предоставляя структурированные данные для медиамониторинга и аналитики.
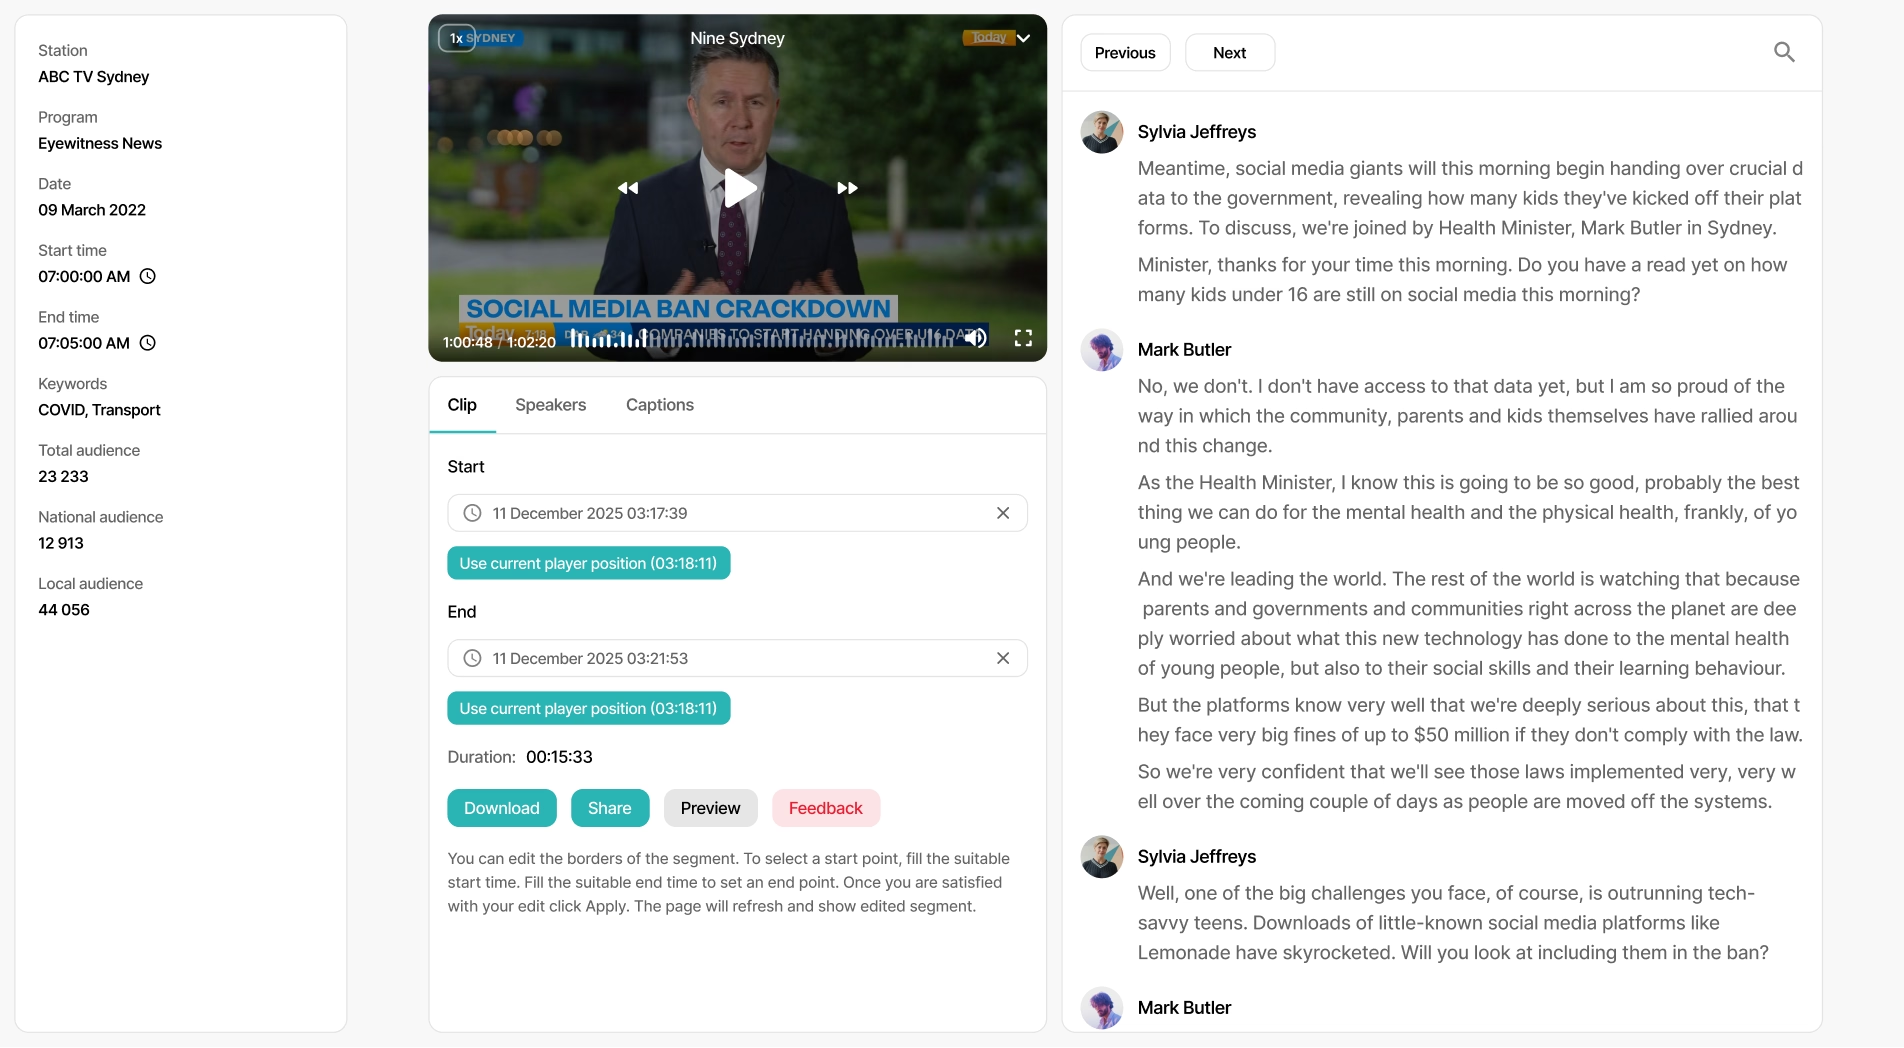
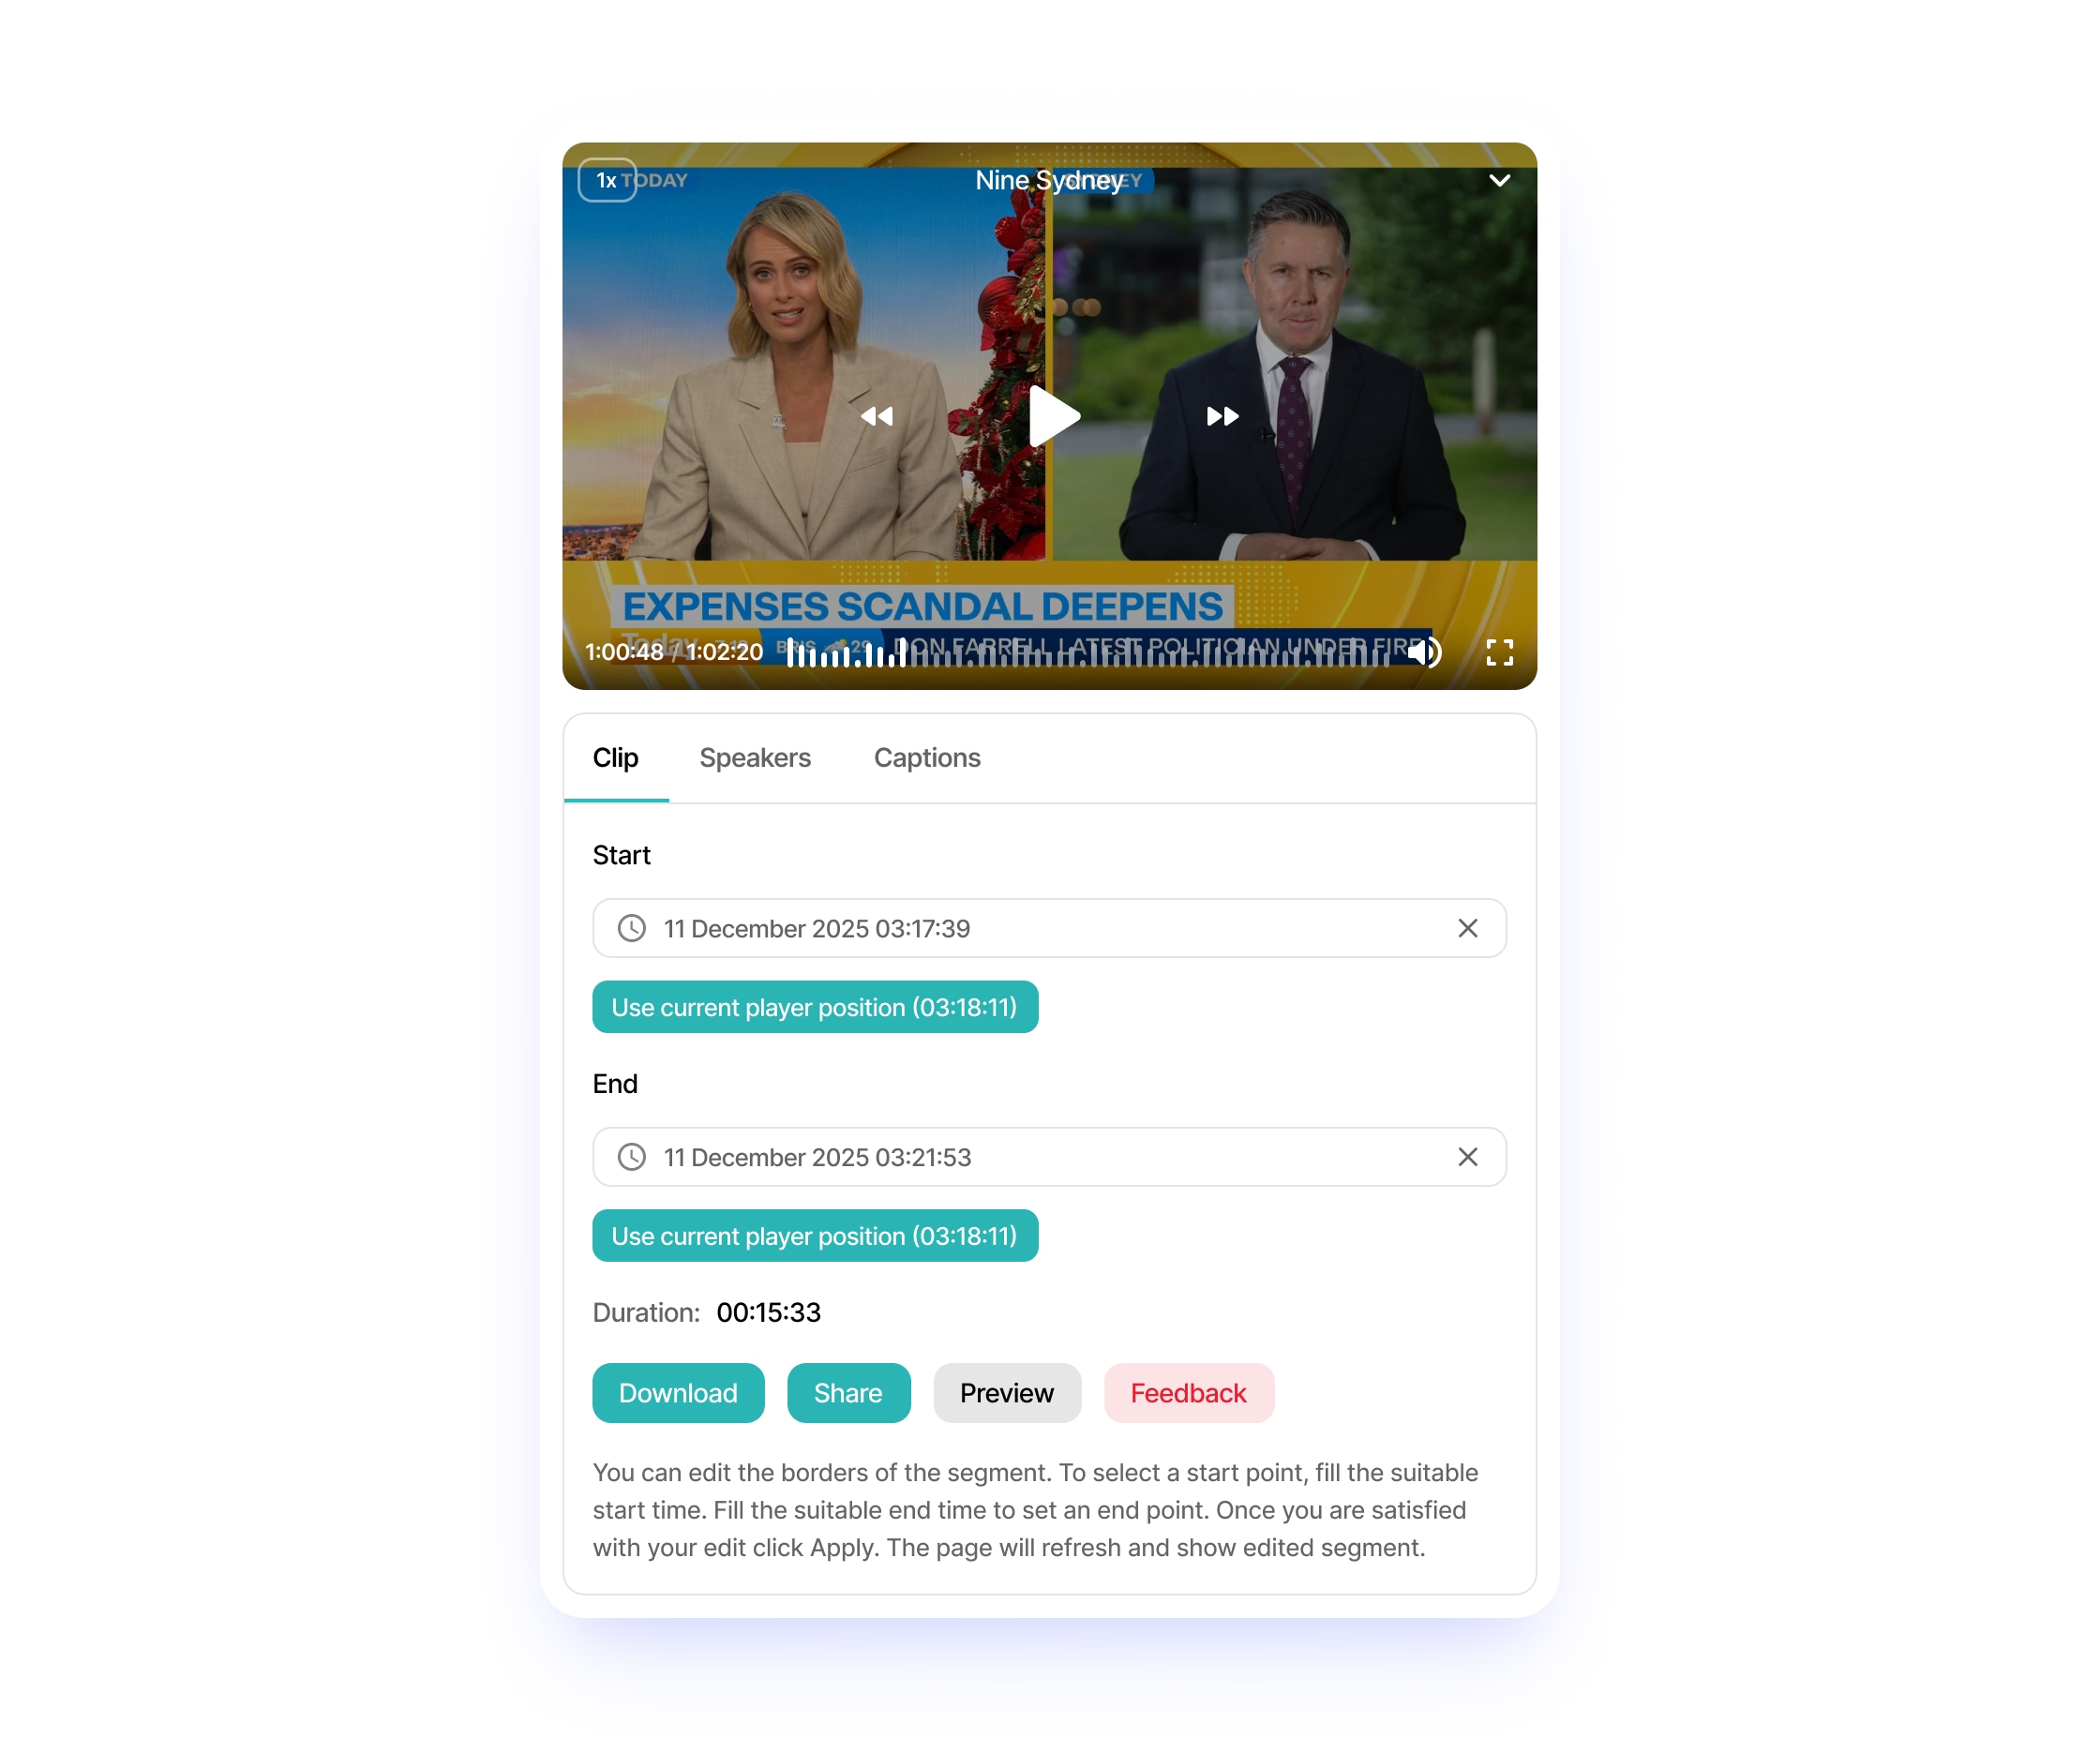
Плеер для просмотра теле- и радиостанций
Удобный веб-интерфейс для просмотра и навигации по обработанным записям теле- и радиопередач. Плеер интегрирует результаты анализа: отображает расшифровку речи синхронно с воспроизведением, выделяет сегменты (сюжеты, рекламные блоки), помечает распознанных спикеров, показывает распознанный текст нижней трети. Позволяет быстро переходить к интересующим фрагментам на основе метаданных.
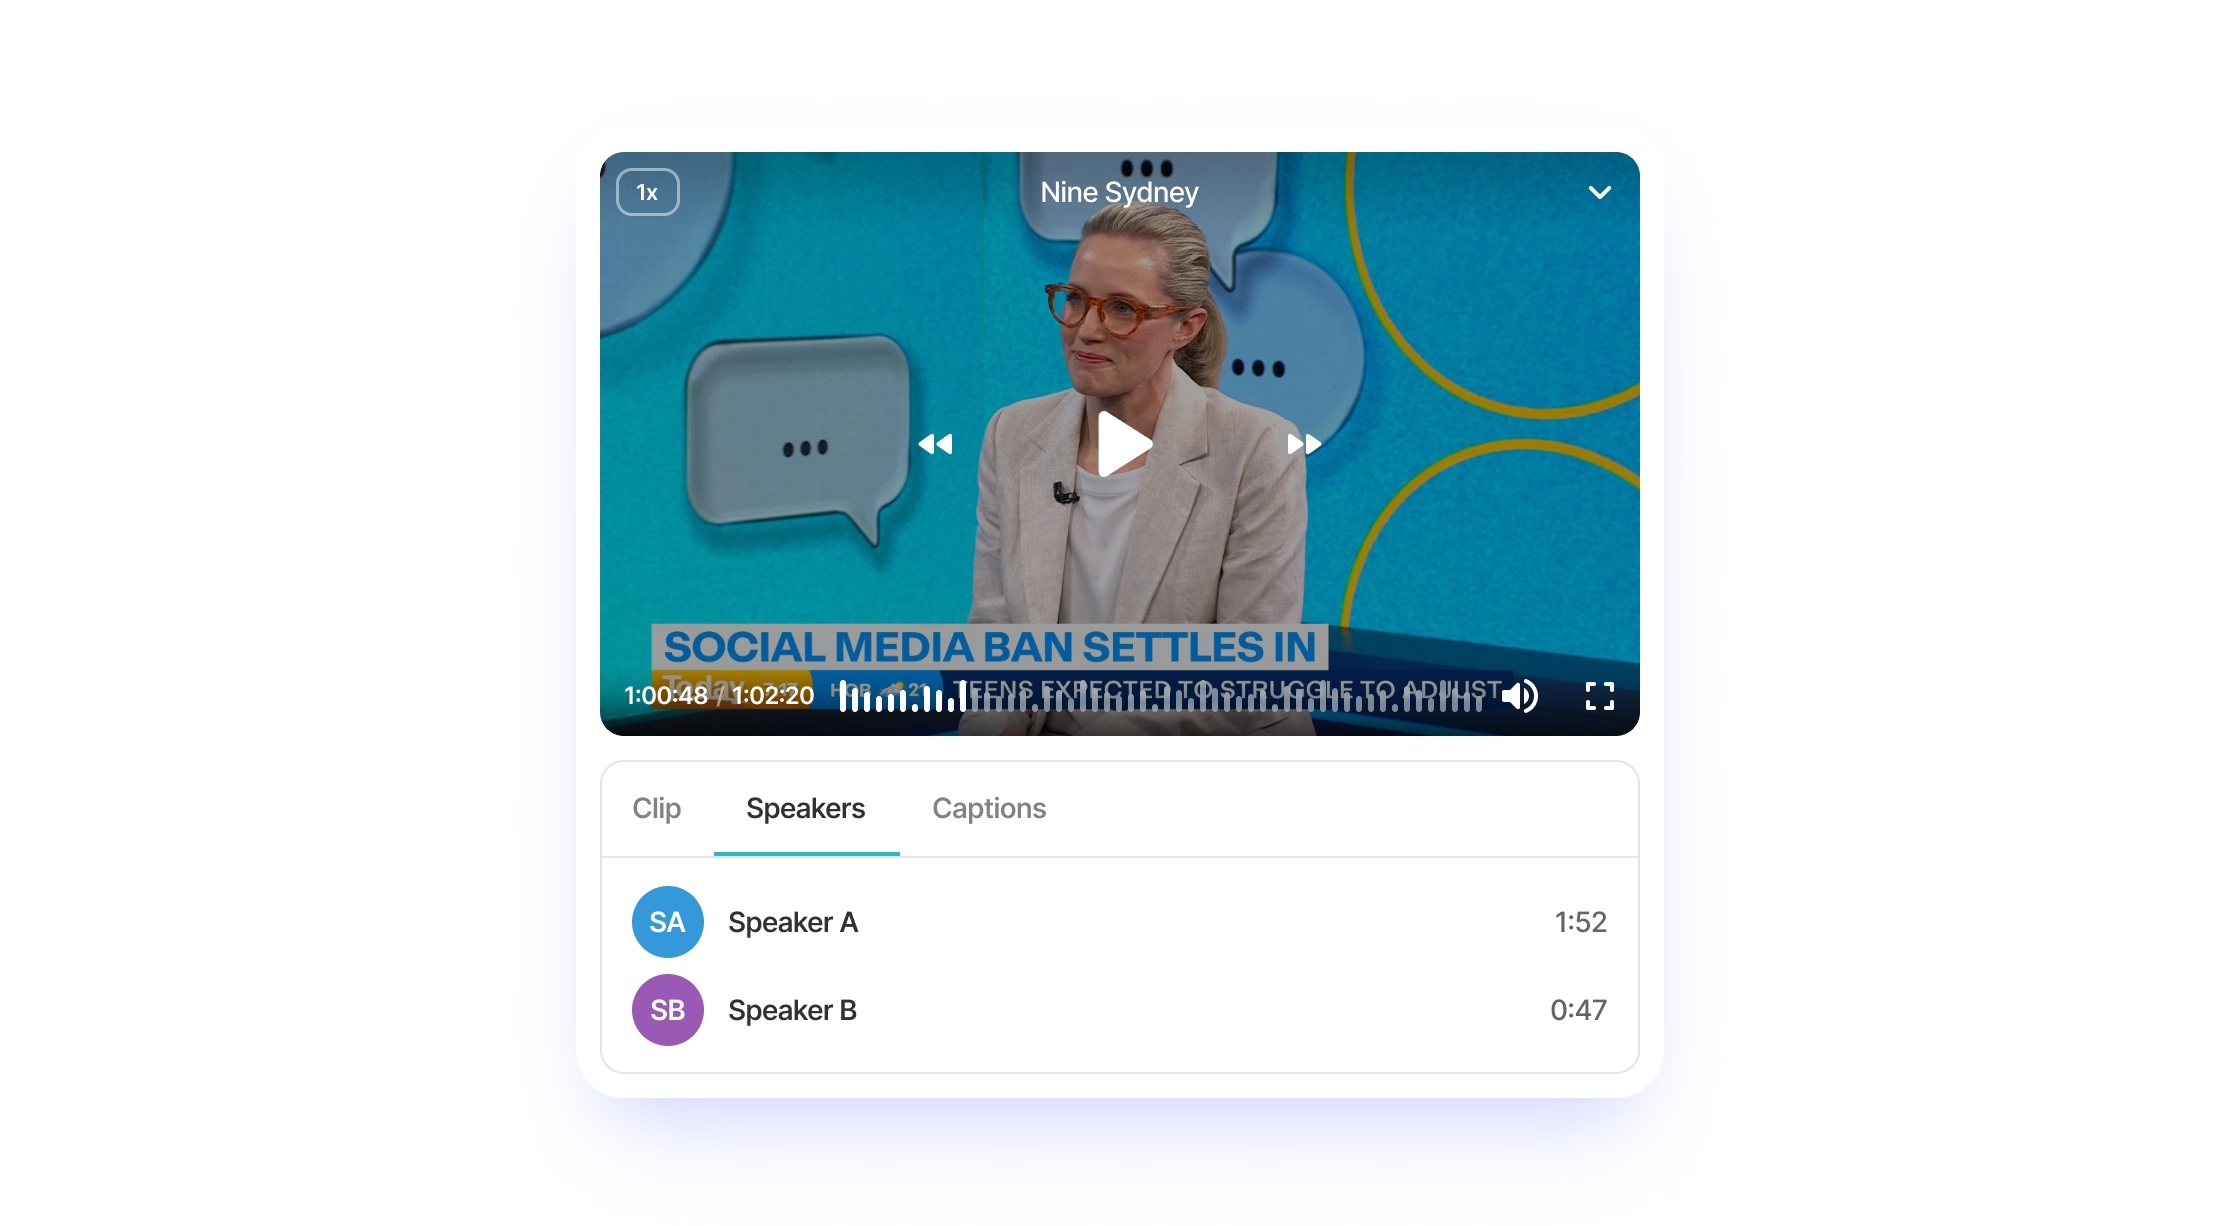
Распознавание спикеров
Двойная технология идентификации спикеров в видео- и аудиопотоке: по уникальным характеристикам голоса (голосовые отпечатки) и по визуальным признакам лица. Система автоматически размечает смену говорящих в диалогах (диаризация) и сопоставляет их с записями в базе данных спикеров, обеспечивая точную атрибуцию высказываний.
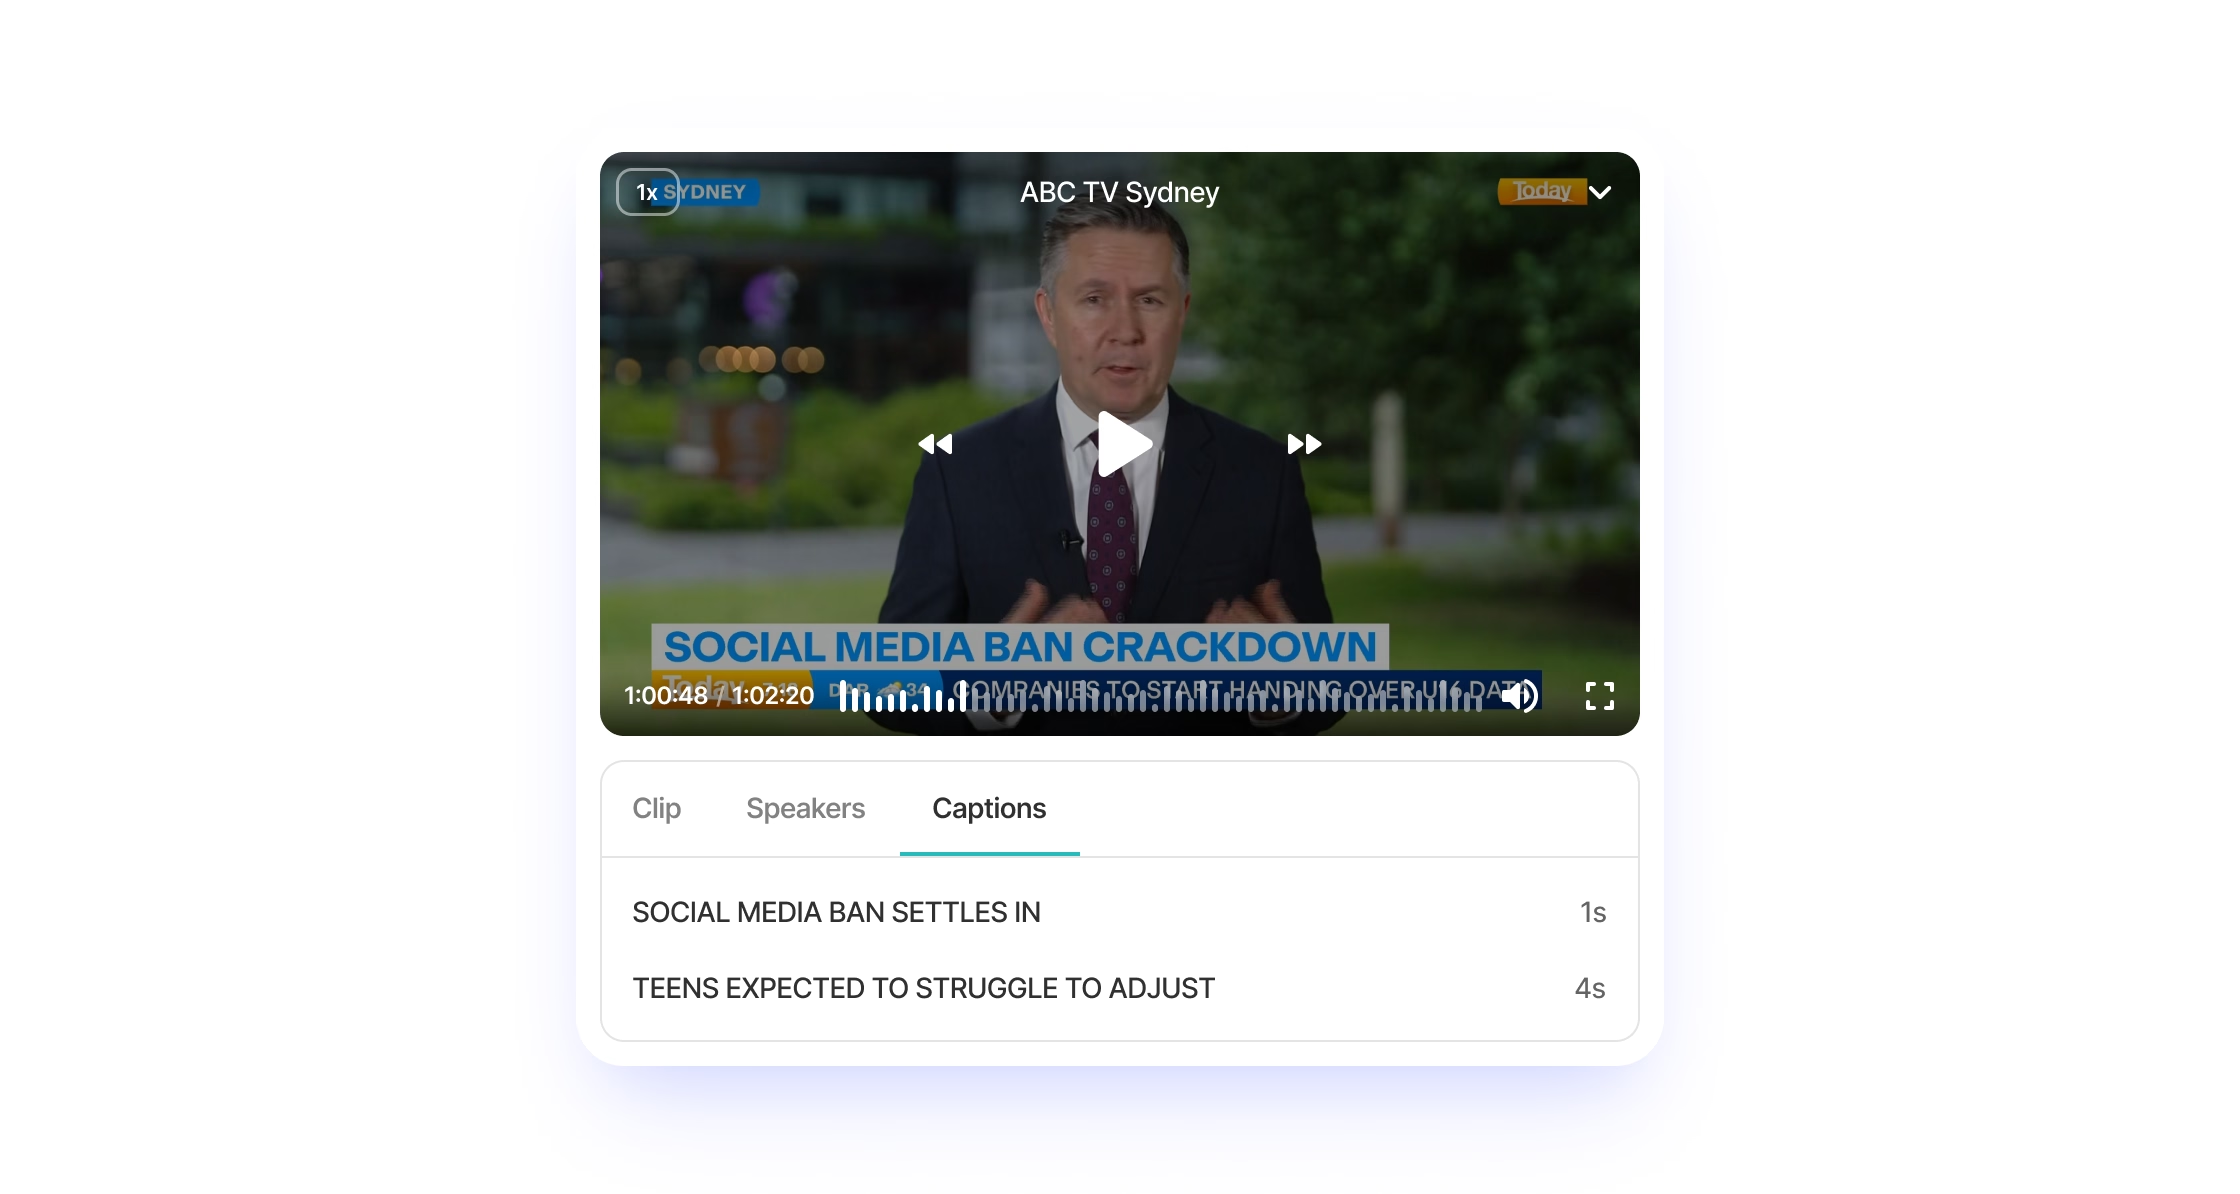
Распознавание текста нижней трети (лейблов)
Функция автоматического обнаружения и распознавания текста, накладываемого в нижней части экрана (субтитры, бегущие строки, имена спикеров, названия сюжетов, логотипы). Позволяет извлекать дополнительную контекстную информацию, имена, названия организаций, ключевые слова, которые могут не звучать в эфире, для более полного анализа и индексации контента.