Портфолио
Портфолио

Анализатор бегущей строки

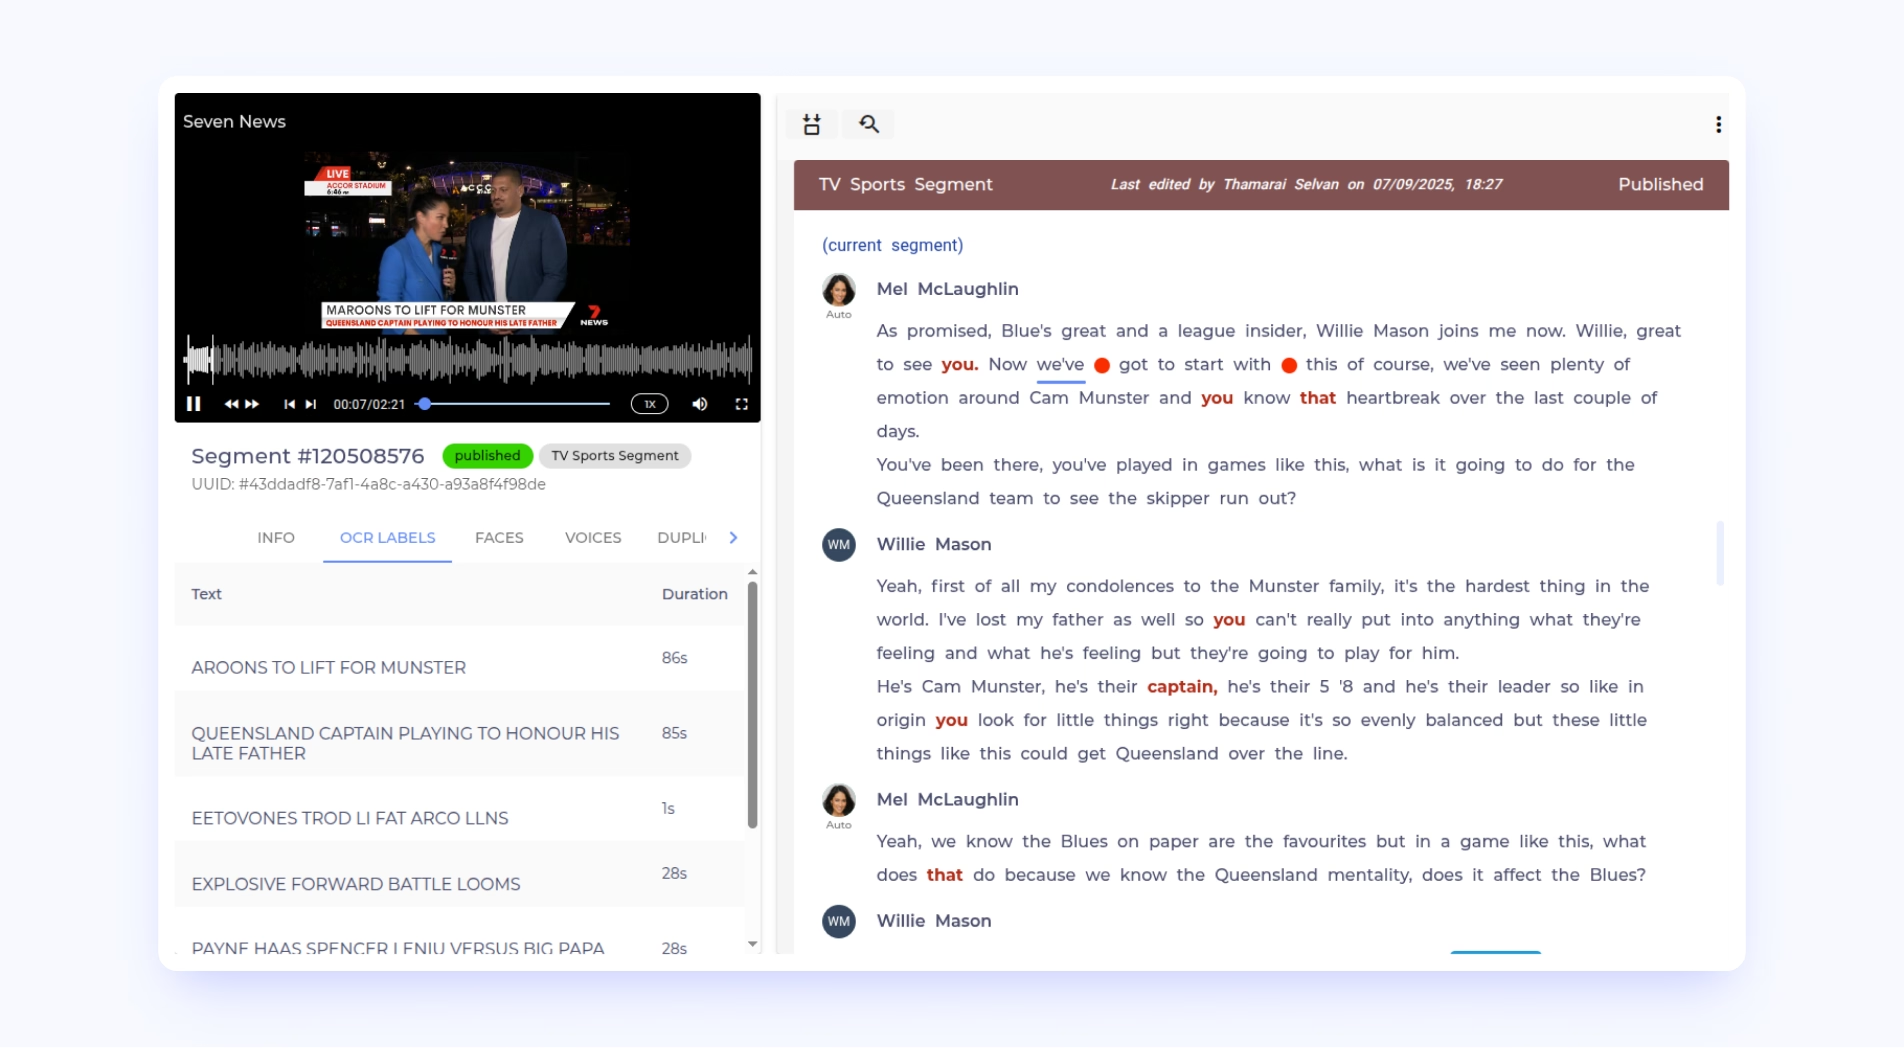
Инструмент мониторинга и анализа видеоконтента, использующий компьютерное зрение и обработку естественного языка для автоматического распознавания текста в бегущих строках и нижних третях (лейблах) телевизионных новостных выпусков. Система обеспечивает сбор структурированных данных, извлечение ключевой информации (имена, должности, события) и интеллектуальное сегментирование видеопотока на смысловые блоки.
Заказчик
Австралийская PR-платформа
Развиваем проект с 2021 года
Основная проблема
Мониторинг телевизионного эфира вручную — крайне трудоемкий и медленный процесс, подверженный человеческому фактору. Отсутствие автоматизации затрудняет оперативное реагирование на появление ключевых персон или событий в эфире, делает невозможным быстрый поиск и анализ конкретных сюжетов в больших массивах видеоархивов и не позволяет масштабировать процесс мониторинга.
Ключевая задача
Разработать высокоточный и настраиваемый инструмент для автоматического детектирования положения нижней трети на видео, распознавания текста на ней (включая сложные условия: разный фон, шрифты, качество картинки) и преобразования речи диктора в текст. Решение должно автоматически структурировать полученные данные, извлекать метаданные (спикеры, темы) и разделять видеозапись на логические сегменты для упрощения навигации, поиска и формирования отчетов.
Стек технологий
  • FFmpeg
  • TesseractOCR
  • OpenCV
  • EAST
Интерфейс распознавания бегущей строки в видеоэфире

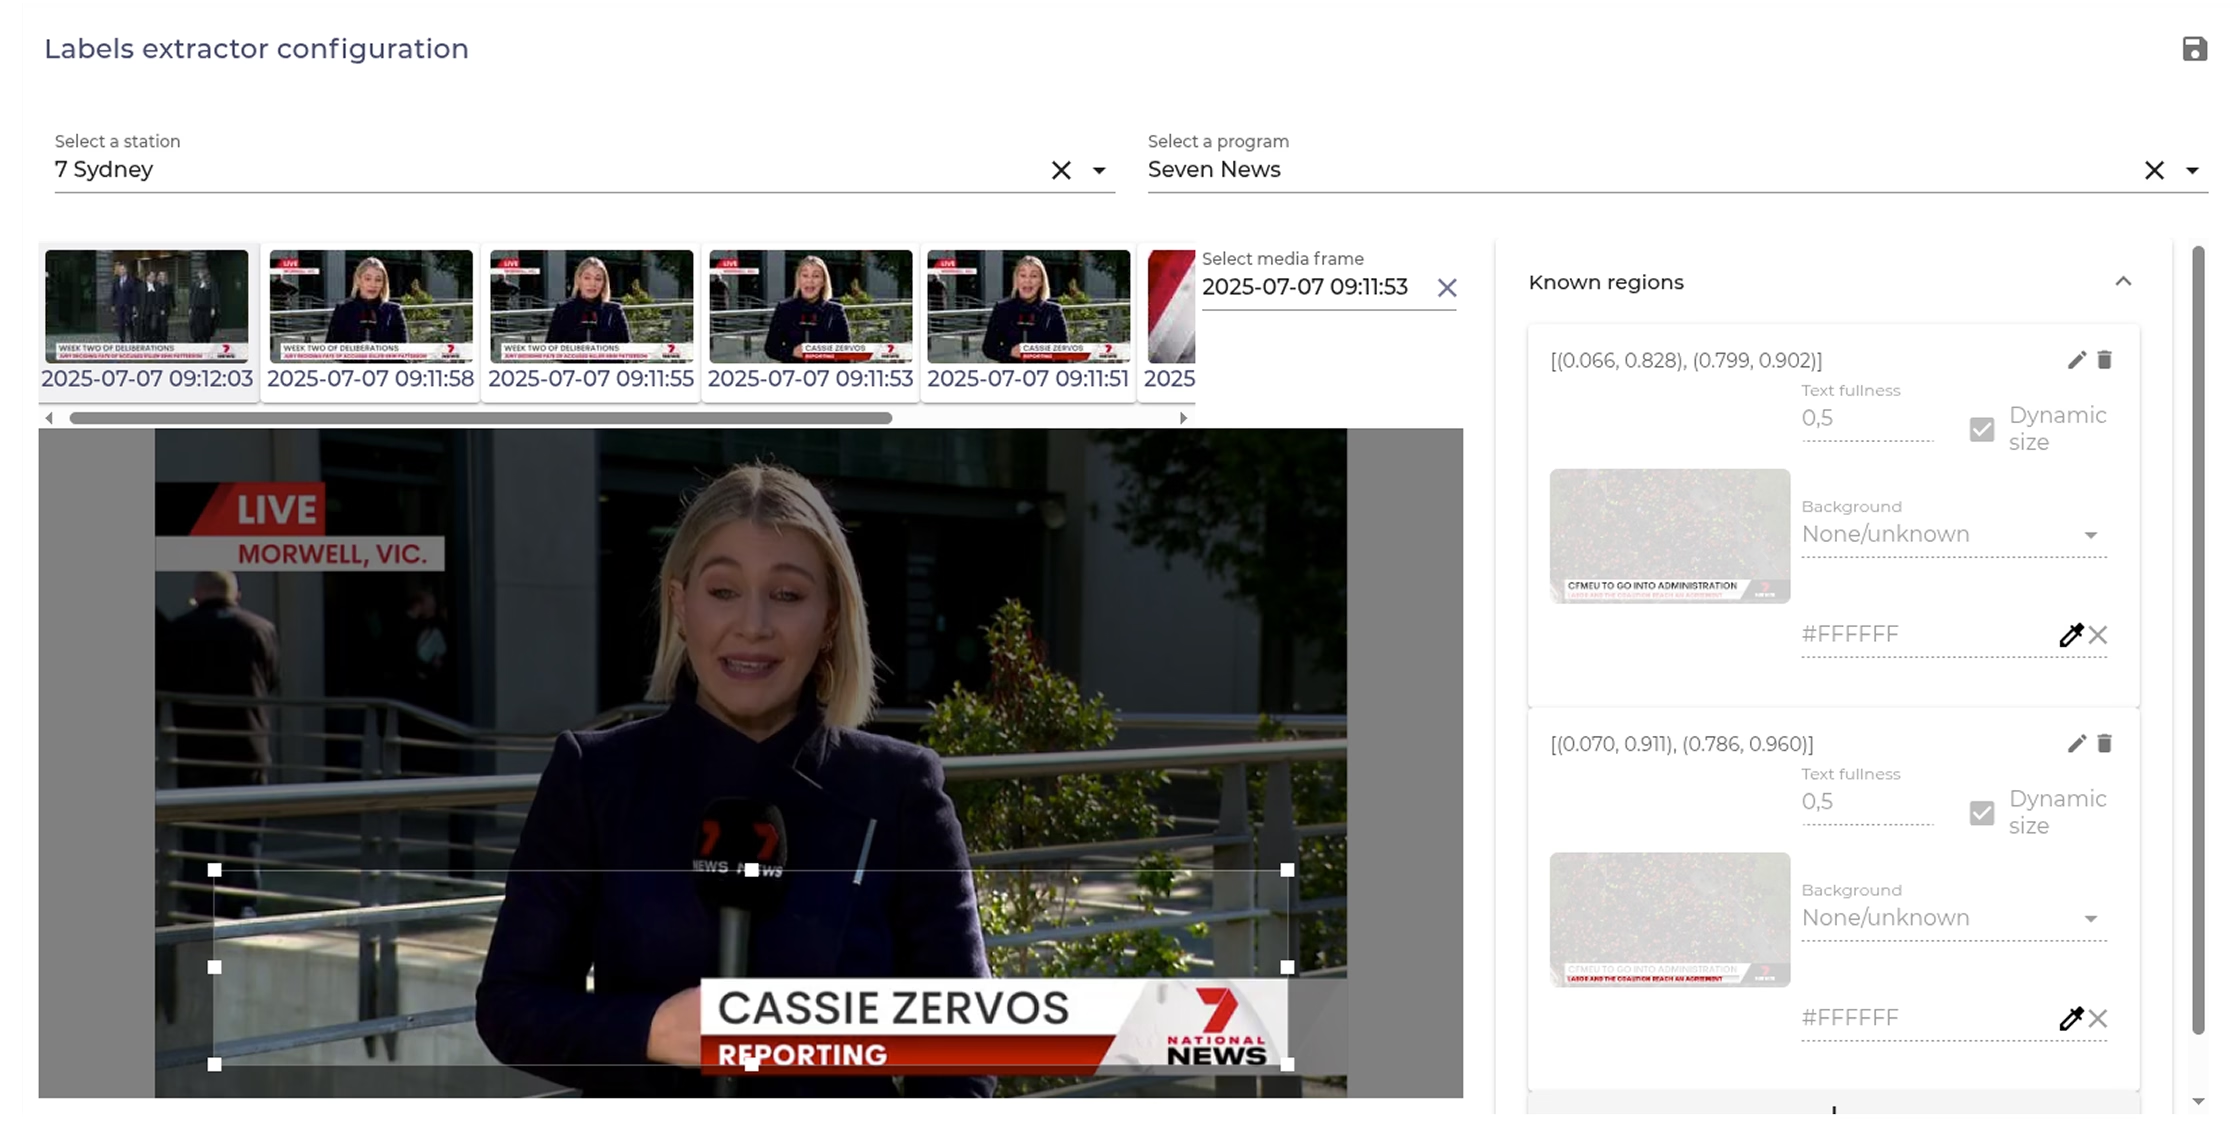
Настройка конфигураций нижней трети (лейбла)

Система позволяет создавать уникальные шаблоны конфигураций для каждой телепрограммы или новостного выпуска. Для максимальной точности распознавания текста настраиваются визуальные параметры лейбла: цвет фона и шрифта, размер и тип шрифта, точная ширина и высота области, а также ее поведение (статистичная или динамичная/появляющаяся). Это обеспечивает высокую точность детектирования и адаптивность инструмента под любой канал.
Настройка конфигураций нижней трети (лейбла)